O cerere, mai multe probleme de inginerie
Un model lingvistic poate oferi un răspuns util într-o demonstrație și totuși să nu facă față aceleiași sarcini în condiții reale de utilizare. Procesarea intrării, viteza de generare, consumul de memorie și calitatea răspunsului sunt constrângeri distincte. Dacă înțelegi traseul inferenței, poți identifica mai ușor cauza unei probleme.
Articolul urmărește un Transformer autoregresiv de tip decoder-only, arhitectură folosită de numeroase modele de text aflate în exploatare. Encoderele multimodale, straturile mixture-of-experts și alte arhitecturi de procesare a secvențelor adaugă particularități. Calculele de mai jos sunt exemple explicite, nu măsurători ale unui sistem implementat de Nikba.
De la conversație la distribuția probabilităților pentru următorul token
Aplicația serializează instrucțiunile, mesajele conversației, documentele recuperate și rezultatele instrumentelor în formatul de intrare cerut de model. Un tokenizer transformă această reprezentare în identificatori de tokenuri. Delimitarea depinde de tokenizer: un cuvânt, un fragment de cod sau o expresie într-o altă limbă poate ocupa mai multe tokenuri.
Modelul combină reprezentările tokenurilor cu informația despre poziție și le transformă prin straturi succesive. În mecanismul de autoatenție cauzală, o poziție poate folosi pozițiile anterioare și propria poziție, în timp ce pozițiile viitoare sunt mascate. Proiecțiile query, key și value determină contribuția informației din pozițiile accesibile la reprezentarea curentă.
Attention(Q, K, V) = softmax(QKᵀ / √dₖ + causal_mask)VReprezentarea finală produce scoruri pentru elementele vocabularului, numite logits. O regulă de decodare folosește aceste scoruri pentru a selecta următorul token. Parametrii modelului au fost deja ajustați în timpul antrenării; inferența obișnuită îi utilizează fără să îi modifice. Lucrarea originală despre Transformer explică mecanismul de atenție, deși arhitectura completă descrisă acolo include atât un encoder, cât și un decoder.
Prefill și decodarea au limitări diferite
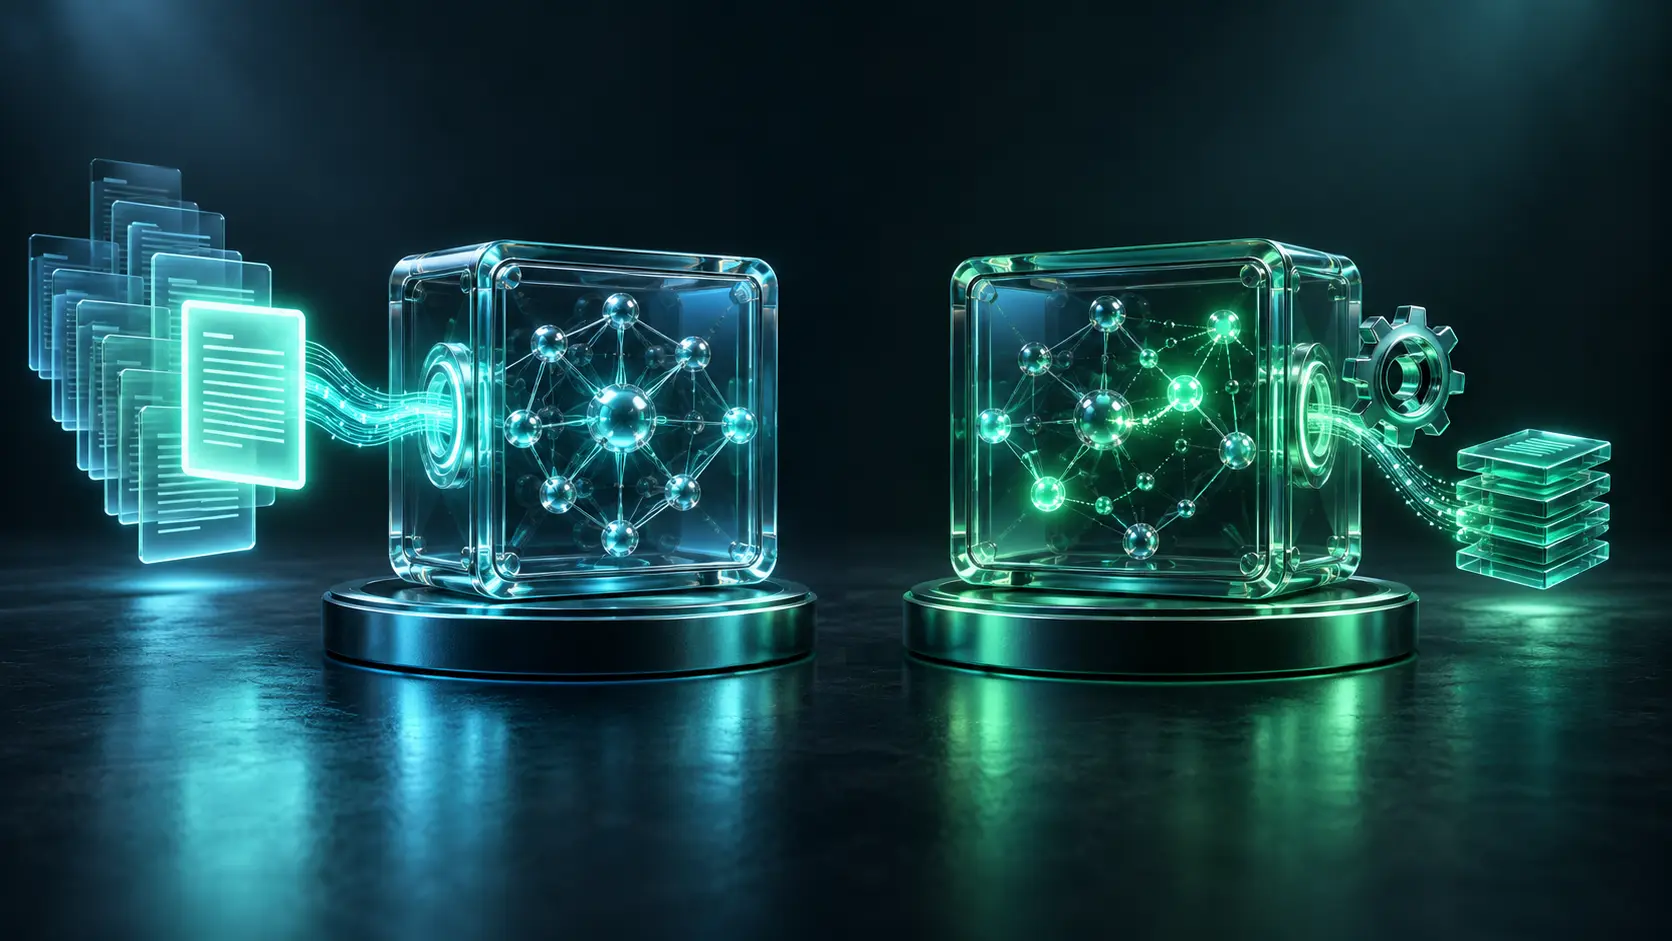
În etapa prefill, serverul procesează secvența de intrare cunoscută și pregătește starea necesară generării. O parte importantă a calculelor pentru pozițiile de intrare poate fi paralelizată. La decodare, fiecare token nou extinde secvența și condiționează pasul următor. În generarea autoregresivă convențională, un răspuns lung necesită numeroși pași succesivi de decodare.
De aceea, timpul până la primul token și numărul de tokenuri generate pe secundă descriu etape diferite ale experienței. Așteptarea în coadă, căutarea documentelor, transferul prin rețea și operațiile aplicației contribuie și ele la latența percepută. Un decoder rapid nu compensează o coadă de cereri supraîncărcată. Analiza NVIDIA privind inferența explică compromisurile de calcul și memorie dintre aceste etape.
Pentru un asistent ipotetic care lucrează cu documente, măsoară căutarea separat de etapa prefill. Dacă atât răspunsurile scurte, cât și cele lungi încep cu întârziere, verifică timpul în coadă, căutarea și lungimea intrării. Dacă primul token apare repede, dar finalizarea durează, verifică lungimea ieșirii, viteza de decodare și numărul cererilor simultane. Acestea sunt ipoteze de diagnostic care trebuie verificate în datele de execuție.
Cache-ul KV reduce calculele repetate, dar consumă memorie
Un server autoregresiv poate păstra cheile și valorile calculate anterior, în loc să le recalculeze la fiecare pas. Cache-ul KV este o optimizare a inferenței. Nu este o colecție de fapte verificate, o bază de cunoștințe a companiei sau un înlocuitor al contextului modelului.
Pentru un model cu atenție completă, o primă estimare a memoriei cache pentru o singură secvență este:
Memorie KV în octeți ≈ 2 × straturi × tokenuri_păstrate × capete_KV × dimensiune_cap × octeți_per_element

Ipotezele exemplului:
32 de straturi × 32 768 de tokenuri × 8 capete KV × 128 de dimensiuni
2 tablouri (K și V), fiecare cu elemente de câte 2 octeți

2 × 32 × 32 768 × 8 × 128 × 2 = 4 294 967 296 de octeți ≈ 4 GiB
Estimarea nu include ponderile modelului, activările, costurile suplimentare ale alocării memoriei sau alte cereri. Alte tipare de atenție, formate de cache și metode de cuantizare schimbă rezultatul. Calculul explică de ce un model care încape în memoria acceleratorului poate totuși eșua când sosesc simultan mai multe conversații lungi. Documentația Hugging Face despre strategiile de cache prezintă variante cu proprietăți diferite privind memoria, latența și compilarea; alegerea depinde de sarcina serverului.
Decodarea controlează variația, nu corectitudinea faptelor
Decodarea greedy selectează la fiecare pas un token cu scor maxim. Eșantionarea introduce variație; temperatura și filtrarea candidaților modifică distribuția folosită pentru selecție. O temperatură mică nu transformă o afirmație plauzibilă într-una verificată. Un răspuns repetabil poate conține în continuare o eroare factuală.
Păstrează aceleași versiuni de model, format al promptului și setări de decodare când compari modificările aplicației. Stabilește un buget de ieșire și condiții de oprire potrivite. Consultă documentația despre generare pentru strategiile acceptate, fără să presupui că toți furnizorii oferă aceiași parametri.
Decodarea speculativă poate propune mai multe tokenuri și le poate verifica folosind modelul țintă. Algoritmii care păstrează distribuția pot accelera generarea fără să schimbe distribuția țintă, însă viteza depinde de rata de acceptare a propunerilor și de costurile de servire. Nu există un factor universal de accelerare. Lucrarea despre decodarea speculativă descrie metoda.
Raționamentul adaugă un buget suplimentar de inferență
Unele modele de raționament sunt antrenate să genereze etape intermediare extinse înainte de răspuns. DeepSeek-R1 este un exemplu documentat de aplicare a învățării prin recompensă la comportamentul de raționament. Rezultatul nu demonstrează că orice sarcină beneficiază de o deliberare mai lungă sau că explicația generată redă fidel calculele interne ale modelului.
Într-un produs, compară bugetele de raționament pe sarcini reprezentative. O clasificare cu reguli stricte și o problemă de planificare în mai multe etape pot necesita setări diferite. Compară latența și costul suplimentar cu proporția rezultatelor corecte și utilizabile. Include situații în care sistemul trebuie să ceară informații lipsă sau să evite o afirmație fără suport.
Un plan de măsurare înainte de alegerea unui model mai mare
Construiește un set restrâns, versionat, de cereri: solicitări scurte, documente lungi, cod, intrări multilingve și rezultate de instrumente caracteristice aplicației. Testează la un nivel realist de concurență. Înregistrează timpul în coadă, tokenurile de intrare și ieșire, timpul până la primul token, latența finalizării, presiunea asupra memoriei și succesul sarcinii. Analizează latențele p50 și p95, pentru ca mediile să nu ascundă cererile lente.
Modifică pe rând câte un factor: modelul, lungimea contextului, materialele recuperate, setările de decodare sau configurația serverului. Un criteriu ilustrativ de acceptare poate cere un răspuns corect susținut de o sursă validă înainte de a considera cererea reușită. Pragul numeric trebuie stabilit pornind de la cerințele produsului și măsurătorile inițiale, nu de la o țintă generică de tokenuri pe secundă.
Pentru următoarea decizie de arhitectură, continuă cu RAG sau fine-tuning. Pentru sisteme care execută acțiuni, citește despre agenți AI fiabili.
Knowledge Base · 10 întrebări tehnice
Analiză tehnică
Analizează deciziile de arhitectură și cazurile de eroare, apoi compară argumentele cu explicația.
01 De ce un model poate încăpea în memorie, dar poate eșua la cereri simultane cu context lung?
Răspuns
Ponderile reprezintă doar o parte din consumul de memorie. Fiecare secvență activă poate necesita un cache KV considerabil, pe lângă activări și costurile suplimentare ale serverului.
02 Ce ipoteze folosește calculul de 4 GiB pentru cache?
Răspuns
O secvență cu atenție completă, 32 de straturi, 32 768 de tokenuri păstrate, 8 capete KV, dimensiunea capului 128 și elemente de câte doi octeți pentru chei și valori.
Ponderile, costurile alocatorului și celelalte secvențe nu sunt incluse; alte mecanisme de atenție și formate de cache modifică estimarea.
03 De ce măsurăm separat latența prefill și viteza de decodare?
Răspuns
Prefill procesează intrarea cunoscută; decodarea extinde secvența. Tiparele lor de calcul diferă și pot reacționa diferit la lungimea contextului și la cererile simultane.
04 Inferența obișnuită actualizează ponderile modelului?
Răspuns
Nu. Inferența obișnuită folosește parametrii existenți. Actualizarea ponderilor necesită un proces separat de antrenare sau adaptare.
05 Ce păstrează cache-ul KV?
Răspuns
Tensorii key și value calculați anterior și folosiți de mecanismul de atenție. Păstrarea lor nu demonstrează că informația reprezentată este corectă.
06 Temperatura zero garantează corectitudinea faptelor?
Răspuns
Nu. Selectarea tokenurilor cu scor mare poate face răspunsul mai repetabil, fără să elimine erorile factuale.
07 Ce poate păstra decodarea speculativă?
Răspuns
Un algoritm speculativ care conservă distribuția poate păstra distribuția ieșirilor modelului țintă în timp ce propune și verifică mai multe tokenuri.
Accelerarea reală depinde de rata de acceptare, de hardware și de costurile de servire.
08 De ce lungimea de context anunțată pentru un model nu este suficientă pentru dimensionarea sistemului?
Răspuns
Nu indică memoria, latența sau precizia realizabile cu acel context la numărul de cereri simultane așteptat de aplicație.
09 Cum alegem bugetul de raționament?
Răspuns
Comparăm succesul sarcinilor, latența și costul pe intrări reprezentative, la mai multe bugete acceptate. Generarea intermediară mai lungă nu este întotdeauna avantajoasă.
10 Ce trebuie să rămână constant într-o comparație a inferenței?
Răspuns
Setul de evaluare, versiunea modelului unde este cazul, formatul promptului, configurația de decodare și condițiile de încărcare, cu excepția factorului testat intenționat.